
 Libros
 Aventuras
 Ciencia ficción
 Fantasía
 Grandes clásicos
 Literatura contemporánea
 Novela histórica
 Novela negra, misterio y thriller
 Poesía
 Novela romántica
 Literatura juvenil
 Arte, música y fotografía
 Autoconocimiento y salud
 Biografías e historias reales
 Ciencia ficción juvenil
 Ciencia, tecnología y naturaleza
 Novela fantástica juvenil
 Libros juveniles de Influencers
 Novelas juveniles
 Novela romántica juvenil
 Novela juvenil de aventuras
 Poesía juvenil
 Thriller juvenil
 Tiempo libre (juvenil)
 Biografías
 Ciencia y tecnología
 Economía, política, sociedad y actualidad
 Filosofía
 Historia
 Autoayuda
 Espiritualidad
 Familia y crianza
 Nutrición, belleza y fitness
 Arte, cine y música
 Business
 Cocina
 Guías y literatura de viajes
 Tiempo libre
 Uso de la lengua y diccionarios
 Cómic de autor
 Cómic juvenil
 Cómic de no ficción
 Cómic infantil
 Cómic de humor
 Cómics de influencers
 Cómic
 Manga
 Bolsillo
 Audiolibros
 Audiolibros de ficción
 Audiolibros de ciencia, historia y sociedad
 Audiolibros de salud y bienestar
 Audiolibro práctico y de ocio
 Audiolibros infantiles
 Audiolibros juveniles
 Autores
 Editoriales
 Revista lengua
 Penguinkids
 Recomendaciones
 Tienda: Argentina


Your cart
No hay más artículos en su carrito


¿QUÉ ES EL AZAR?
A punto de comenzar un partido de fútbol, ¿qué equipo debe dar inicio al juego? Bueno, lo más justo, de acuerdo con los usos y costumbres deportivos, es que eso quede al arbitrio del azar, lanzando una moneda.
¿Qué puede tener de justo dejar nuestros destinos, aunque se trate de un simple juego, a merced del azar? Después de todo, no utilizamos una moneda para resolver otro tipo de conflictos humanos tales como una pensión de alimentos. Pero en el caso de un partido de fútbol la razón no tiene mucho que aportar. Nadie tiene más merecimiento para poner la pelota en marcha y, lamentablemente, solo un equipo puede hacerlo. La solución entonces es que la salomónica arbitrariedad sea simétrica, que la probabilidad de comenzar sea la misma para cada equipo, es decir, 50 por ciento.
La noción de probabilidad es tan familiar que casi no parece necesario explicarla. Es parte de nuestro instinto científico y lo utilizamos cotidianamente desde los pocos meses de vida.4 Pero cuando queremos llevarla al terreno de la razón, definirla, explicarla, las cosas dejan de ser tan obvias. Y es muy importante hacerlo por dos razones. Primero, porque al alejarnos un poco de los problemas más sencillos en donde la probabilidad juega algún papel, el sentido común deja de ser una buena guía y caemos en las más peligrosas trampas. Segundo, porque queremos entender en cierta profundidad la naturaleza del azar, gran protagonista de este libro.
Pero a pesar de la familiaridad, no es fácil formalizar el concepto de probabilidad. De hecho, los matemáticos trabajaron por mucho tiempo en este asunto, y solo en el siglo XX con los trabajos de Andréi Nikoláyevich Kolmogórov se llegó a la comprensión contemporánea del azar.5 No intentaremos aquí mostrar estos desarrollos con la precisión que un matemático demandaría, pero será necesario al menos adquirir algunas nociones intuitivas y generales del asunto. La estrategia será partir con una definición provisional, abstracta, basada en nuestras intuiciones, para luego darle mayor solidez a través de test empíricos.
Partamos con el proverbial ejemplo de la moneda. Supongamos que esta se encuentra perfectamente balanceada y es del todo simétrica. Ambos lados serían indistinguibles si no fuera por los dibujos que diferencian la cara de la cruz. Al lanzarla, por lo tanto, el resultado sería impredecible, incluso si conociéramos muchos resultados previos. Ningún lado tiene ventaja alguna sobre el otro. Es imposible construir una estrategia que asegure ganar dinero apostando a esa moneda. Ya que al lanzarla hay dos resultados posibles y equiprobables, decimos que cada uno de ellos tiene ½ de probabilidad de salir o, lo que es lo mismo, un 50 por ciento.
Parece sencillo pero ya veremos cómo, al intentar generar criterios empíricos que nos permitan testear el azar, las dificultades revelarán una mayor profundidad conceptual. Antes de eso respondamos una pregunta que algunos lectores podrían estar haciéndose: ¿qué pasa si queremos definir una probabilidad distinta al 50 por ciento? No hay mayor problema. Basta generalizar la moneda a objetos que den lugar a más resultados posibles. Un dado, por ejemplo, tiene seis. Una vez más, imaginamos un dado perfectamente simétrico de modo que ninguno de sus lados tenga ventaja sobre otro y el resultado sea impredecible. Entonces, la probabilidad de que salga cualquiera de sus lados es 1/6 o, aproximadamente, un 17 por ciento. Si quisiéramos obtener una probabilidad el doble de grande, pintaríamos de a pares las caras del dado de distintos colores y, de este modo, la probabilidad de que salga uno de ellos sería de 2 sobre 6, es decir, de 1/3. Así, usando dados con un número suficientemente grande de caras y pintando las que sean necesarias, podremos acercarnos a cualquier probabilidad que deseemos definir.6
TESTEANDO EL AZAR
Un lanzamiento único de una moneda solo puede tener un resultado, por lo que claramente no nos dará ninguna pista sobre su aleatoriedad. Si la lanzamos dos veces tampoco obtendremos mucha información, ya que incluso obteniendo dos caras no podríamos concluir que la moneda esté cargada. Para obtener información empírica sobre la aleatoriedad de la moneda debemos lanzarla muchísimas veces.
Por comodidad en el análisis, etiquetaremos los dos posibles resultados de cada lanzamiento como «0» o «1» para «cara» o «cruz» respectivamente. Comencemos con un número pequeño de lanzamientos, digamos, cuatro. El número de resultados posibles es 2 × 2 × 2 × 2 = 16, y son los siguientes:
| 0000 | 0001 | 0010 | 0011 |
| 0100 | 0101 | 0110 | 0111 |
| 1000 | 1001 | 1010 | 1011 |
| 1100 | 1101 | 1110 | 1111 |
Que la moneda sea justa significa que cada uno de estos resultados es tan probable como cualquier otro. En un comienzo esto puede parecer extraño. Pareciera que la secuencia 1001 fuese «más aleatoria» que 1111. Pero es evidente que ambas tienen exactamente la misma probabilidad de ser el resultado del experimento. ¿Por qué entonces tenemos esta errónea impresión? La razón de esta falsa intuición radica en el hecho de que 1001 es, en cierto sentido, una secuencia más típica. De las 16, son solo dos las que tienen cuatro dígitos iguales, 0000 y 1111 (grupo A), frente a las seis que tienen igual número de unos y ceros: 0011,0101, 0110, 1001,1010, 1100 (grupo B).
Así, una secuencia del grupo B es más común y tiene mayor probabilidad de aparecer que una del grupo A. Pero, permítanos insistir, 1001 tiene idéntica probabilidad de aparecer que 1111. Es solo cuando comparamos la probabilidad de que aparezca cualquier secuencia del grupo B con aquella de que aparezca cualquier secuencia del grupo A cuando podemos afirmar que lo primero es más probable. De hecho, vemos que tiene 3 veces más probabilidad (6 secuencias versus 2).
Usando la misma lógica podemos definir dos grupos más. Aquel en donde están las secuencias que tienen un solo 1 (0001,0010,0100,1000) y las que tienen un solo 0 (1110,1101,1011,0111), a las que llamaremos, respectivamente, grupos C y D. Cada uno de ellos contiene 4 secuencias, por lo que alguna de ellas aparecerá con el doble de probabilidad de aquellas correspondientes al grupo A.
A medida que consideremos secuencias más y más largas el número de combinaciones con igual número de unos y ceros crecerá mucho más rápidamente que cualquier otra. Es así como las secuencias «visualmente» más aleatorias son, en efecto, apabullantemente más probables de aparecer. Por ejemplo, tomemos ahora secuencias con 100 dígitos. El número de posibles resultados es enorme:
2100 = 1.267.650.600.228.229.401.496.703.205.376
De todas estas posibilidades, nuevamente solo dos tienen todos los dígitos iguales (0000... y 1111...). La probabilidad de que aparezca una de estas secuencias es de apenas 2 en el número de 31 dígitos expuesto arriba, al que podemos redondear en un quintillón. Para hacerse una idea de lo improbable que es ello, hagamos el siguiente experimento. Tomemos una tira larga de papel y dividámosla en milímetros. Supongamos que la cinta da una vuelta completa a la Tierra. Ahora, como si fuese una ruleta planetaria, lancemos una pequeña bolita que pueda aterrizar en cualquiera de los casilleros milimétricos. ¿Apostaría por alguno? Es probable que no. Aunque, a decir verdad, esta apuesta es abrumadoramente más factible de ser exitosa que la de obtener 100 veces la misma cara de una moneda. Para hacerlas similares, habría que disponer de un quintillón de casilleros y eso obligaría a que la cinta alcanzara a las galaxias más lejanas y diera toda la vuelta al universo observable. Una ruleta literalmente cósmica.
¿Cuántas secuencias tendrán el mismo número de ceros y de unos en el experimento de las 100 monedas? ¡Muchísimas! Un 8 por ciento del total, aproximadamente. Es decir, existen buenas chances de que salga alguna de ellas. La probabilidad de que obtengamos 49 ceros y 51 unos es casi igual de alta, como cabría esperar. Sin embargo, al aumentar la diferencia entre unos y ceros la probabilidad cae en forma abrupta. Podemos graficar estos números para hacernos una mejor idea de estas probabilidades.
La parte superior de la Figura 1 ilustra el caso que estamos tratando. El eje horizontal muestra números desde el 0 hasta el 100. La vertical indica el número de secuencias que tienen ese número de unos. Vemos como cerca del 50 alcanza una cantidad enorme de 1029. Abajo exactamente lo mismo, pero ahora para secuencias de 1000 lanzamientos. Podemos observar dos características que diferencian estos dos gráficos.
Primero, los números en el eje vertical. Abajo las secuencias con tantos unos como ceros llegan a 10299. Estos son números tan inconmensurablemente enormes que no podemos proponer un ejemplo para hacernos una idea. Ni siquiera el número de partículas elementales en todo el universo observable, unas 1086, se acerca a estas magnitudes.
Segundo, la curva cae mucho más abruptamente al pasar los quinientos unos. Está más concentrada, más apretada en torno a la región central.
Este tipo de curva aparece mucho cuando hacemos cálculos estadísticos que involucran probabilidades. Es conocida como curva normal o campana de Gauss. En este caso nos muestra cómo al aumentar el número de lanzamientos, la cantidad de secuencias con el mismo número de unos y ceros crece de manera exorbitante. De este modo, podemos afirmar que, idealmente, cuando las secuencias son de infinitos lanzamientos, tendremos la mitad exacta de dígitos de cada tipo. Esta es la noción matemática de infinito, pero en la práctica es suficiente para cualquier aplicación testear la moneda un número grande de veces. ¿Cuán grande? Dependerá del uso que queramos darle al lanzamiento.
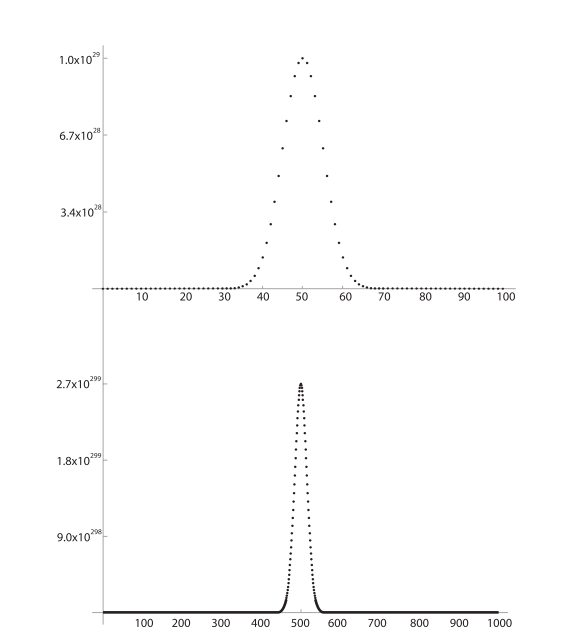
Figura 1. Arriba, el número de secuencias con diferentes números de 1 en 100 lanzamientos. Abajo en 1000 lanzamientos.
Podemos ilustrarlo con un bonito ejemplo basado en un método que, al aprovecharse de las leyes del azar, fue bautizado como método de Montecarlo y concebido por dos grandes físicos a mediados de la década de 1940: Stanislaw Ulam y John von Neumann. Si dibujamos el círculo más grande posible dentro de un cuadrado, es fácil convencerse de que el cociente de sus áreas7 será igual a π/4. Si arrojáramos al aire granos de arena de manera aleatoria y luego contáramos cuántos cayeron dentro del círculo y cuántos dentro del cuadrado, el cociente de estos números debería aproximarse a π/4 si el lanzamiento fue realmente aleatorio. Un análisis más cuidadoso nos permitirá constatar que cada factor 100 en el número de granos se traducirá en una cifra decimal de precisión. Para calcular, por ejemplo, π = 3.1416, tendremos que lanzar 100 millones de granos de arena.
EL TEOREMA DEL MONO INFINITO
Lamentablemente, no basta con saber que el número de caras y de cruces es el mismo para poder decir que estamos en presencia de una moneda justa. Supongamos, por ejemplo, que lanzamos muchísimas veces la moneda, infinitas en la práctica, y obtenemos el siguiente resultado:
0101010101010101010101010101010101010101...
El número de unos y de ceros es el mismo, pero no se trata de una secuencia aleatoria, ya que el patrón es claro y predecible. Para entender con precisión lo que aquí ocurre, leamos la secuencia de dos en dos:
0101010101010101010101010101...
Vista así, está claro que se trata de la repetición infinita de un solo patrón: el grupo «01». Pero este representa solo una de las cuatro posibilidades que existen con dos dígitos:
00, 01, 10, 11
Si la moneda fuese justa y los lanzamientos aleatorios, cada una de estas parejas de dígitos (llamémoslas «palabras») debería tener exactamente la misma probabilidad de aparecer en la secuencia. Después de todo, es lo mismo que le exigimos a las palabras de un solo dígito, «0» y «1». El azar exige que cada una de las cuatro palabras de dos dígitos aparezca un cuarto de las veces.
Podemos seguir y seguir con este juego. Tomar las cuatro palabras de dos dígitos, ponerlas una al lado de la otra, 00011011, y repetir esta palabra de 8 dígitos hasta el infinito:
0001101100011011000110110001101100011011...
La secuencia obtenida obedece nuestras dos exigencias: tiene el mismo número de ceros y de unos, y las cuatro palabras de dos dígitos aparecen en idéntica proporción. Pero, evidentemente, no tiene nada de aleatoria: solo una de las 256 posibles palabras de 8 dígitos aparece en la secuencia infinita.
A estas alturas debería comenzar a resultar claro cuál es la exigencia que debemos imponer a una secuencia infinita y aleatoria de ceros y unos. Esta es sencilla de formular en los términos presentados: si consideramos palabras de cualquier número de dígitos, todas las posibilidades deberán aparecer en igual número.8 Por ejemplo, las 16 palabras de 4 dígitos que analizamos en la sección anterior deben aparecer la misma cantidad de veces en una secuencia aleatoria infinita. Y así para cualquier tamaño de palabra: las 2N palabras que pueden formarse con N dígitos deben ser equiprobables, para todos los valores de N.
El azar es una exquisita abstracción intelectual que demanda gran familiaridad con el infinito. Pero el infinito o, en la práctica, los números suficientemente grandes, escapan a todo sentido común y nos regalan una amplia variedad de paradojas. Una de las más conocidas es la del teorema del mono infinito, introducida por el célebre matemático francés Émile Borel en 1913.9 Esta paradoja imagina un mono presionando los botones de un teclado de forma por completo aleatoria. El animal producirá una secuencia infinita de letras con todas las propiedades de las secuencias numéricas de las que hablamos antes.
Cada vez que el mono va a presionar una tecla es como si lanzara un dado con 30 lados, cada uno con una de las 27 letras del abecedario español más el espacio, el punto y la coma. Ahora bien, si consideramos una secuencia de, digamos, 360.000 caracteres tecleados, tendremos una cantidad de letras suficientemente grande como para llenar un libro de 200 páginas. De este modo, si la secuencia infinita de caracteres impresa por el mono la dividimos en bloques de 360.000 letras, entonces tendremos un conjunto de infinitos libros fruto de su aleatoria autoría. Como todos tienen la misma probabilidad de aparecer, allí deberán estar todos los libros escritos en la historia y todos los que alguna vez vayan a escribirse10 (si el libro que imaginamos tiene más de 200 páginas, podríamos dividirlo en tomos; si tiene menos, rellenaríamos el resto con espacios en blanco). De hecho, ya que la secuencia es infinita, ¡cada libro aparecerá infinitas veces!
Este hecho, tan fascinante como poco intuitivo, fue explotado por Jorge Luis Borges en su cuento «La biblioteca de Babel». Estas disquisiciones son poco intuitivas dados los gigantescos números que involucran. Si lanzamos un dado de 30 lados que representan a todas las letras 360.000 veces, por ejemplo, la cantidad de secuencias distintas que podemos obtener es
30360.000 ≈ 4 × 10531.763
un número de más de 530.000 dígitos, tan absurdamente grande que resulta inconcebible. Ya vimos que el número de partículas elementales contenidas en el universo observable tiene menos de 90 dígitos. Evidentemente, casi todas las secuencias corresponderán a textos sin sentido ni significado. Una minúscula parte, sin embargo, es literatura.
En términos temporales, si el mono presionara las teclas dos veces por segundo estando en frente de la máquina de escribir, sin pausa, desde el Big Bang, solo habría escrito unas 1018 letras. Solo porque el universo no es suficientemente viejo, el mono no ha escrito La odisea o Crimen y castigo.
LA TRAMA SE COMPLEJIZA
Para la mayoría de las situaciones, los criterios arriba descritos resultan suficientes para caracterizar inequívocamente el azar. Sin embargo, existen muchas secuencias infinitas de dígitos que, cumpliéndolos, aún no son aleatorias. Veamos un ejemplo. Imaginemos que somos radioastrónomos y estamos analizando una señal que proviene desde una estrella lejana de nuestra galaxia. Sin entrar en detalles técnicos, digamos que contamos con un equipo que transforma las señales en una secuencia de dígitos entre el 0 y el 9. Supongamos que en la pantalla leemos lo siguiente:
3.141592653589793238462643383279502884197169399375105820974944592307816406286208998628034825342117067982148086513282306647093844609550582231725359408128481117450284102701938521105559644622948954930381964428810975665933446128475648233786783165271201909145648566923460348610454326648213393607260249141273724587006606315588174881520920962829254091715364367892590360011330530548820466521384146951941511609433057270365759591953092186117381932611793105118548074462379962749567351885752724891227938183011949129833673362440656643086021394946395224737190702179860943702770539217176293176752384674818467669405132000568127145263560827785771342757789609173637178721468440901224953430146549585371050792279689258923542019956112129021960864034418159813629774771309960518707211349999998372978049951059731732816096318595024459455346908302642522308253344685035261931188171010003137838752886587533208381420617177669147303598253490428755468731159562863882353787593751957781857780532171226806613001927876611195909216420198...
Es decir, recibimos π (pi). Esta larga secuencia cumple con todos los test estadísticos antes discutidos. Cada dígito,
0, 1, 2, 3, 4, 5, 6, 7, 8, 9
aparece con idéntica frecuencia. Arriba, por ejemplo, escribimos en forma explícita los primeros mil dígitos. El número de veces que aparece cada uno, respectivamente, es
93, 116, 103, 103, 93, 97, 94, 95, 100, 106
Mientras más dígitos consideremos, menor será la diferencia porcentual entre estas cantidades. Lo mismo ocurrirá para las cien distintas palabras de dos dígitos
00, 01, 02, 03... 96, 97, 98, 99
y así sucesivamente. De hecho, si tomamos nuestro número de teléfono, las propiedades estadísticas aseguran que podremos encontrarlo allí. Podemos imaginar una variante en miniatura de la biblioteca de Babel, la guía telefónica de Babel, en la que se listen todos los números telefónicos de, digamos, 8 dígitos. Hay cien millones de posibilidades (desde el 00000000 al 99999999). Esto significa que si consideramos, por ejemplo, los primeros 500 millones de dígitos de π, es muy probable que su teléfono este allí, incluso quizás varias veces. Existen numerosas páginas web en las que usted puede poner una secuencia numérica y buscarla en los primeros 500 millones de dígitos de π. Nuestros teléfonos aparecen, respectivamente, 1 y 6 veces (tienen 9 y 8 dígitos, respectivamente) en esos primeros 500 millones de decimales. Busque el suyo y la próxima vez que alguien se lo pida conteste algo así como «Es el que está a partir del dígito 45.235.441 de la expansión decimal de π».
Bueno, todo este desvío fue para insistir en el hecho de que la secuencia infinita de dígitos de π cumple con los test estadísticos que presentamos hasta ahora para concluir que una secuencia es aleatoria.11 Sin embargo, si captamos una señal desde una estrella lejana que codifique una secuencia suficientemente larga de dígitos de π no pensaríamos que se trata de algo aleatorio, producto de fenómenos físicos complejos en la estrella. Estaríamos seguros de que viene de un planeta que orbita la estrella y que hemos hecho contacto con una civilización extraterrestre.
Una forma de caracterizar esta clase de secuencias y descartarlas de entre las que llamamos aleatorias se la debemos a un área distinta de las matemáticas: la teoría de la información. Andréi Kolmogórov fue quien revolucionó el área con su teoría de la complejidad. Uno de sus estudiantes, Per Martin-Löf, fue el primero en estudiar y describir una secuencia aleatoria de manera formal, matemáticamente precisa. Existen muchas maneras de formularla, pero para nuestros propósitos, la más simple, inspirada en ideas de Kolmogórov, es la siguiente:
Una secuencia infinita es aleatoria si no existe una descripción más eficiente que escribirla completa, dígito por dígito.
Para entender esto de manera sencilla, lo mejor es recurrir a ejemplos. La secuencia menos aleatoria posible es una que solo contenga unos (o ceros). Para describirla, comunicársela a alguien, no es necesario dictarle cada uno de sus infinitos dígitos. Podemos simplemente darle dos instrucciones:
(1) escriba 1 y (2) vuelva al paso (1)
Estas dos instrucciones son, claro está, una forma más eficiente de comunicar la secuencia que dictarla dígito a dígito. Lo mismo ocurre con series como 01010101... Allí podemos decir:
(1) escriba 0, (2) escriba 1 y (3) vuelva al paso (1)
Pero la definición de Martin-Löf es más poderosa, ya que captura casos más generales, como el de los dígitos de π. Este número se puede generar con instrucciones muy breves:
(1) mida el perímetro de un círculo, (2) mida su diámetro y (3) divida los resultados.12
Existen algoritmos informáticos muy eficaces para calcular los dígitos de π, de modo que es mucho más eficiente transmitir estas instrucciones que los infinitos dígitos uno a uno.
En este capítulo, en definitiva, intentamos mostrar la dificultad que tiene precisar lo que entendemos por azar. Enfatizamos numerosos ejemplos en los que determinar la presencia o la ausencia del azar en algo en apariencia tan sencillo como una secuencia de números naturales puede demandar una elaboración teórica de creciente sofisticación. Se trata de un concepto muy familiar que el sentido común cree capaz de detectar sin demasiadas dificultades. Pero no es así. Jamás diríamos que Crimen y castigo puede ser fruto de una contingencia aleatoria y, sin embargo, vimos que podría haber sido escrito por el mono infinito de Borel.
Cuando intentamos arrojar sobre el azar una mirada científica, nos encontramos con muchos más problemas de los que ingenuamente podríamos esperar. Es mucho más fácil definir la aleatoriedad en la práctica, cuando tenemos algún conocimiento sobre aquello que le dio lugar. Un dado o una moneda arrojados al aire ofrecen la imagen proverbial de lo que es el azar y, sin embargo, sabemos que podrían estar adulterados y lo trabajoso que sería darnos cuenta de ello.
En este libro intentaremos adentrarnos en una empresa cuya complejidad debería estar clara: determinar si hay fenómenos en la naturaleza que sean estrictamente azarosos. Sistemas en los que el azar no sea fruto de nuestra ignorancia sino un rasgo integral y definitivo que de ninguna manera pueda ser evitado. Veremos, con sorpresa, que la descripción del mundo microscópico es inevitablemente probabilística. Y ello nos llevará a cuestionarnos la naturaleza del determinismo y la propia noción de lo que es la realidad. Pero veremos la enorme dificultad que entraña el poder discernir si el azar es aparente o real. Si hay un conjunto de instrucciones como las sugeridas por Martin-Löf, crípticas y desconocidas, que restauren la certidumbre y desenmascaren la falsa apariencia de aleatoriedad o, por el contrario, es el caprichoso albur del azar el que tiene la última palabra.
EL ORIGEN DEL AZAR EN EL
MUNDO CLÁSICO
Cuando hablamos del «mundo clásico» en este libro, nos referimos a la cosmovisión científica que existía hasta 1925, es decir, antes del advenimiento de la mecánica cuántica. Los físicos solemos hablar hasta nuestros días de lo «clásico» como contraparte de lo «cuántico». Como sabemos que las leyes del universo son las de la mecánica cuántica, esto podría resultar confuso. ¿Para qué seguir hablando de un mundo clásico si este ya fue destronado? Ocurre que esto no es cierto. La mecánica (clásica) de Newton se sigue utilizando en innumerables situaciones por tratarse de una extraordinaria aproximación para lidiar con cuerpos suficientemente grandes y pesados. El mundo clásico, por lo tanto, al igual que las manzanas y los planetas, existe.
En este mundo clásico el azar no tiene cabida. O, para ser más precisos, no está incorporado de manera fundamental en las leyes que lo rigen. Las ecuaciones de Newton para describir el movimiento y las de Maxwell, que dan cuenta de la electricidad, el magnetismo y la luz, parecían los únicos ingredientes necesarios para explicar cualquier fenómeno natural hasta comienzos del siglo XX. Y estas ecuaciones son esencialmente deterministas, sin resquicios por los que pueda colarse el azar.
EL DEMONIO DE LAPLACE
Tomemos las leyes de Newton como base de la discusión (aunque con la teoría de Maxwell ocurra lo mismo, si bien con algunas dificultades técnicas que no tendría sentido tratar aquí). Si conociéramos en un instante dado las posiciones, las masas y las velocidades de todos los objetos del universo, además de la naturaleza de las fuerzas con las que interactúan, entonces podríamos saber en forma exacta dónde estarán en el futuro y dónde estuvieron en cualquier momento del pasado. Por supuesto, esto es algo imposible de implementar en la práctica. Ni siquiera seríamos capaces de determinar las posiciones y velocidades de las moléculas del aire de nuestra propia habitación debido a su enorme cantidad y a las dificultades técnicas de semejante empresa.
Pero no son las limitaciones prácticas las relevantes en esta discusión. Nada nos impide suponer que, con suficiente cuidado y con los recursos oportunos, resulte a priori posible conocer todos los datos mencionados en el párrafo anterior, cuando menos como producto de un ejercicio intelectual, de un experimento mental. Después de todo, no hay nada que lo haga, en principio, imposible. No hay una ley de la naturaleza que lo impida, sino nuestra condición humana. Podemos, por lo tanto, concebir la idea de un ente imaginario que fuera capaz de medir el estado de cada ingrediente del universo con absoluta precisión. En la literatura de la física se le llama Demonio de Laplace, en honor al matemático y físico francés Pierre-Simon Laplace, padre de la criatura. En 1814, en su libro Ensayo filosófico sobre las probabilidades, Laplace afirma:
Debemos entonces considerar el estado presente del universo como el efecto de su estado anterior y como la causa del que le seguirá. Dada, por un instante, una inteligencia capaz de comprender todas las fuerzas que animan la naturaleza y la situación respectiva de los seres que la componen —una inteligencia lo suficientemente vasta como para someter estos datos a análisis—, abarcaría en una misma fórmula los movimientos de los cuerpos más grandes del universo y los del átomo más ligero; para ella, nada sería incierto y el futuro, al igual que el pasado, estaría presente ante sus ojos.13
La capacidad de predecir el futuro que las ecuaciones del movimiento nos otorgan fue uno de los grandes logros de Newton y de toda la física clásica. Esculpió nuestra forma de ver el mundo y de entender la ciencia. Formalizó y precisó el concepto de causa-efecto, tan enraizado en nuestro sentido común que no es concebible la una sin el otro. Grabó en piedra la doctrina del determinismo, que dice que los eventos presentes determinan, de manera completa, única y precisa, cada acontecimiento futuro, así como cada suceso del pasado. En este escenario, poco espacio queda para el azar. Todo es infaliblemente certero.
Uno de los grandes debates que surgieron a raíz de esta concepción del universo fue el del libre albedrío. Si el conocer el estado actual del universo predice todo lo que ocurrirá en el futuro, ¿tiene sentido hablar de la libertad de nuestra voluntad? Si nos sentamos a pensar si continuaremos escribiendo estas líneas en este preciso instante o acaso emplearemos el tiempo en algún otro asunto, ¿será esta una decisión realmente libre o, por el contrario, un conjetural Demonio de Laplace ya conocía lo que haríamos, incluso antes de que se formara el Sistema Solar?
Esta es una discusión relevante en filosofía y tiene importantes consecuencias éticas: ¿somos responsables de nuestros actos? Porque, de otro modo, ¿cómo condenar a un asesino si su comportamiento estaba predeterminado por las leyes de la naturaleza incluso antes de su nacimiento? La vívida sensación que tenemos sobre nuestra libertad de decidir y actuar, sin duda, entra en contradicción con el determinismo clásico. Arthur Schopenhauer fue uno de los primeros en tratar este problema señalando que, si bien es cierto que una persona puede afirmar «hago lo que quiero» en un intento por exhibir su libre albedrío, es en realidad aquello que esa persona quiere lo que no depende en absoluto de su voluntad. En su libro Sobre la libertad de la voluntad humana, de 1841, afirmó: «Puedes hacer lo que quieras: pero puedes, en cualquier momento de tu vida, querer solo una cosa definida y absolutamente nada más que esta única cosa».14
Volveremos sobre esto más adelante con nuevos elementos de juicio, pero preferimos adelantar, para evitar cualquier ansiedad o malentendido, que la mecánica cuántica no nos ayudará a resolver este dilema.
¿Es posible el azar en un universo clásico, determinista? Por supuesto que sí, de lo contrario no podrían existir los casinos. Pero este es un azar que no tiene ninguna relación con las leyes de la naturaleza. Su origen proviene de un hecho tan simple como incontestable: no somos demonios de Laplace. Somos seres pequeños, limitados y en esencia ignorantes, y en nuestro desconocimiento residen la ventura y la desventura.
El azar del mundo clásico no está en la naturaleza. Vive en nosotros.
EL EFECTO MARIPOSA
Predecir es un ejercicio que los humanos realizamos en todo momento. Es, y ha sido, una eficaz herramienta de supervivencia evolutiva. Tomamos decisiones de acuerdo a estas predicciones y modificamos nuestras estrategias predictivas por prueba y error a través de la experiencia. Este es un comportamiento instintivo, innato en nuestra especie. Por ejemplo, si tenemos una reunión a las ocho de la manaña en el otro extremo de la ciudad, debemos de algún modo decidir a qué hora salir de casa. Ni muy temprano, para no perder tiempo esperando, ni muy tarde, para no exponernos al riesgo de llegar después de la cita. Tenemos que tomar una decisión que prediga nuestra llegada a tiempo. Esto es la práctica de la ciencia en su sentido más elemental.
Ahora bien, hay una característica de algunos fenómenos del mundo clásico que experimentamos a menudo y que muchas veces nos confunde, llevándonos a tomar malas decisiones: el caos. El caos tiene una definición matemática precisa, pero comenzaremos describiéndolo de una manera informal, siguiendo con el ejemplo de nuestra reunión matutina. Podríamos pensar, con algo de ligereza, que si salimos quince minutos más tarde de casa llegaremos aproximadamente quince minutos más tarde a destino. Así, si el día anterior nos comunican que la reunión se pospone para las ocho y cuarto porque nuestro anfitrión tuvo un problema de última hora, actualizaremos nuestros planes proyectando salir un cuarto de hora después. Pero alguien que conozca bien la ciudad sabrá que esto no es siempre así. Muchas veces la dinámica del tráfico en las calles puede amplificar sustancialmente esos quince minutos que postergamos nuestra salida, transformándolos en, digamos, una hora y media. Porque esos minutos pueden hacer la diferencia entre un escenario de calles despejadas y otro de intolerable congestión vehicular, promovida, por ejemplo, por la entrada de los niños a los colegios. Esta amplificación de cualquier modesta variación en las condiciones iniciales es la característica sustancial que define a los sistemas caóticos.
Uno de los primeros en entender y caracterizar eso que hoy llamamos caos fue el físico escocés James Clerk Maxwell, el mismo que formuló las ecuaciones de la electricidad y el magnetismo. En un coloquio dictado el 11 de febrero de 1873 afirmó:
Cuando el estado de las cosas es tal que una variación infinitesimal del estado presente altera únicamente en una cantidad infinitesimal el estado en algún momento futuro, se dice que la condición del sistema, ya sea en reposo o en movimiento, es estable; pero cuando una variación infinitesimal del estado presente puede generar una diferencia finita en el estado del sistema en un tiempo finito, se dice que la condición del sistema es inestable.15
Aquí «variación infinitesimal» significa un cambio muy pequeño. Los quince minutos de nuestro ejemplo. Por el contrario, en este contexto se entiende por «diferencia finita» una significativa: la hora y media del ejemplo. Faltaba más de un siglo para que Yien Li y James Yorke acuñaran el término «caos».16 Maxwell, con menos dramatismo pero más precisión lingüística, hablaba entonces de «sistemas inestables».17
En un sistema caótico típico la amplificación de las variaciones es enorme. Quizás nadie lo haya expresado con mayor claridad que uno de los fundadores de la teoría del caos, el matemático y meteorólogo estadounidense Edward Lorenz, quien con el título de una de sus conferencias grabó para siempre en la cultura la imagen más icónica del caos: «¿Puede el batir de alas de una mariposa en Brasil causar un tornado en Texas?». Ilustraba con una imagen contundente cómo una ínfima perturbación en la atmósfera podría tener consecuencias enormes en su comportamiento futuro.
Por poco intuitivo que nos resulte, el caos es la situación genérica en